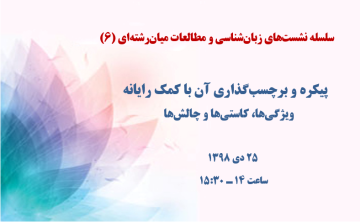
موضوع رویداد
رویداد دورهای
محورهای سخنرانی
فرایند استفاده از رایانه به عنوان ابزار برچسبگذاری داده زبانی چیست؟
چگونه میتوان با برچسبگذاری رایانشی داده، زمان و هزینه را کاهش داد؟
چه چالشهایی را به هنگام تحلیل زبانشناختی داده فارسی مواجه میشویم؟
سخنران
مدیر پنل
زمان برگزاری
تا
مکان
پژوهشگاه علوم و فناوری اطلاعات ایران، تالار سخن
فایل پیوست
دریافت نسخه PDF
(5.93 مگابایت)
چکیده
امروزه پیکره زبانی جایگاه ویژهای را میان زبانشناسان و افرادی که در حوزه زبان و رایانه فعالیت میکنند به خود اختصاص داده است. ازجمله ویژگیهای پیکره این است که باید نماینده زبان باشد. برآوردهسازی این ویژگی منجر به تهیه پیکرهای با حجم زیاد میشود. تحلیل زبانشناختی این حجم زیاد پیکره بسیار زمانبر و پرهزینه است؛ بنابراین استفاده از رایانه میتواند یک راهکار باشد. در این سخنرانی در مورد استفاده از رایانه به عنوان ابزار کمکی در برچسبگذاری داده زبانی توضیح داده میشود و به بررسی ویژگیها و کاستیهای این روش میپردازد. از آنجا که خط فارسی داده ورودی به رایانه برای برچسبگذاری است، با چالشهای فراوان مربوط به خط فارسی روبهرو میشویم که آگاهی از این چالشها میتواند به کاهش کاستیهای برچسبگذاری خودکار منجر شود.
کلیدواژه