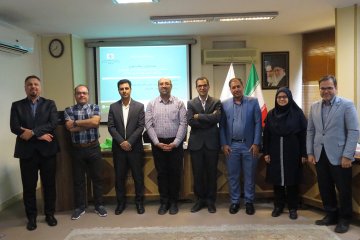
دانشجو: حمید حسنی
استاد راهنما: دکتر محمدجواد ارشادی، دکتر آزاده محبی
استاد مشاور: دکتر عمار جلالی منش
استاد داور: دکتر عباس احمدی، دکتر مهدی قطعی، دکتر محمد ربیعی
هدف: رشد فناوری، گسترش زیرساختهای ارتباطی و بحران همهگیر COVID-19، منجر به افزایش روزافزون آموزش الکترونیکی شده است. یکی از راههای سازماندهی و دسترسی به این حجم از اطلاعات، نمایهسازی با استفاده از روشهای خودکار است. از اینرو در این پژوهش دو هدف اصلی مدنظر است. هدف نخست توسعه یک روش نمایهسازی خودکار برای دادههای چندرسانهای علمی فارسی است. هدف دوم از این پژوهش ارائه چارچوبی است که در آن ابعاد جدید کیفیت داده در حوزه نمایهسازی دادههای چندرسانهای علمی تعریف شود. از آنجایی که نمایهسازی دادههای چندرسانهای علمی شامل مراحل مختلفی است و به صورت یک فرآیند انجام میشود، چارچوب پیشنهادی حاوی ابعاد جدیدی است و رویکرد یکپارچه جدیدی را برای ارزیابی روش یا الگوریتم نمایهسازی از ابتدا تا انتهای این فرآیند معرفی میکند. کاری که در پژوهشهای پیشین صرفاً در انتهای فرآیند و با استفاده از معیارهای شناخته شدهای مانند دقت و بازخوانی انجام شده است.
روششناسی پژوهش: در این پژوهش روششناسی تحقیق علمی طراحی (DSRM) به عنوان چارچوب روششناسی این پژوهش قرار میگیرد. این روششناسی شامل شش گام است، به طوری که در گام اول به موضوع نمایهسازی خودکار دادههای چندرسانهای علمی به صورت یک مسئله نگاه میشود، در گام دوم اهداف راهحلها ارائه و در گام سوم یک مصنوع در قالب یک روش نمایهسازی خودکار برای دستیابی به اهداف ایجاد میشود، و در گام چهارم کارایی عملکرد روش توسعه داده شده بررسی میشود. در گام پنجم از این روششناسی، ابعادی از کیفیت داده در حوزه نمایهسازی تعریف میشود و روش نمایهسازی توسعه داده شده با این ابعاد مورد ارزیابی قرار میگیرد. در مرحله ششم از این روششناسی، اشتراکگذاری نتایج و ارائه پیامدهای علمی و اجرایی پژوهش انجام میشود.
یافتهها: در این پژوهش الگوریتمی به نام LVTIA برای نمایهسازی دادههای چندرسانهای علمی توسعه داده شده است. ارزیابی این الگوریتم در مرحله اول با چهار معیار شناخته شده شامل دقت، بازخوانی، معیار F، و MAP@K و در مرحله دوم با ابعاد جدید تعریف شده در حوزه نمایهسازی چندرسانهای علمی انجام شده است. این ابعاد شامل دقت، ارزش افزوده، مرتبط بودن، کامل بودن، حجم مناسب داده، مختصر بودن، سازگاری، تفسیرپذیری و دسترسی است. یافتههای پژوهش نشان میدهد که عملکرد الگوریتم توسعه داده شده، نسبت به سایر روشها در معیارهای ارزیابی بهتر بوده است. علاوه بر این، ابعاد جدید از جنبههای مختلف با یکدیگر مقایسه شدند. این مقایسه نشان میدهد هر بعدی که برای ارزیابی نمایهسازی دادههای چندرسانهای علمی استفاده میشود، میتواند ضعف یا قوتی متفاوتی از روش یا الگوریتم نمایهسازی را منعکس کند.
نتایج: از این پژوهش میتوان نتیجه گرفت که در فرآیند نمایهسازی دادههای چندرسانهای علمی و توسعه روشها و الگوریتمهای نمایهساز جنبههای مختلفی از کیفیت داده وجود دارد که باید به آنها توجه شود. در مطالعات گذشته در این حوزه برای ارزیابی روشها تمرکز بر روی معیارهای شناخته شدهای مانند دقت و بازخوانی بوده است که همین مسئله باعث شده که سایر جنبههای فنی روشها نادیده گرفته شود. بنابراین لزوم توجه به سایر جنبههای کیفیت داده منجر به توسعه روشها و الگوریتمهای نمایهساز جامعتر و با عملکردی بهتر خواهد شد و در نتیجه این شکاف کمرنگتر میشود.